


Il test del chi-quadro (χ2) serve a saggiare la differenza tra frequenze attese e frequenze osservate.
Le ipotesi sono:
H0: la differenza è dovuta al caso (campionamento, imprecisione, ecc.) oppure a
H1: la differenza è dovuta al fatto che il campione delle osservazioni proviene da una popolazione diversa da quella di cui sono note le frequenze (attese).
Il test consiste nel rapporto (ma in seguito vedremo una formula più corretta):

La tabella indicherà la probabilità di trovare (per caso) un χ2 cosi’ grande. Se la probabilità sarà inferiore al 5% potremo dire che la differenza è significativa. Le frequenze devono essere sempre espresse come frequenze assolute. Mai utilizzare frequenze percentuali o relative.
In generale, se

Dunque non ci stupisce che la quantità:
segua la distribuzione del χ2 con opportuni gradi di libertà.
Ma allora se posso stimare il numero di casi attesi, ad esempio sulla base di un modello probabilistico del sistema che sto studiando, allora posso immediatamente costruire un test per la verifica delle ipotesi.
Esistono numerose applicazioni del test del χ2 . Vediamone alcune.
Test di normalità: goodness-of-fit (bontà di adattamento)
Per testare l’adattamento dei dati alla distribuzione normale è possibile confrontare le frequenze dell’istogramma con le frequenze previste dalla distribuzione normale. Il grafico riporta un istogramma e la curva di distribuzione normale calcolata per la stessa media e deviazione standard.

Per ogni classe esiste quindi una frequenza osservata (colonne) ed una frequenza attesa (curva). Il χ2 ha un numero di gradi di libertà pari al numero delle classi – 3, in quanto abbiamo 3 vincoli: la media e deviazione standard che definiscono la distribuzione normale + una delle classi. Il valore di p ci dirà se le differenze tra le frequenze osservate e le frequenze attese sono significative. Se non sono significative, manteniamo l’ipotesi nulla che assume che la distribuzione dei dati sia compatibile con quella normale.
Nota che le prime e ultime classi con frequenza attesa inferiore a 5 vanno accorpate alle classi adiacenti. Nella figura questo è stato omesso per non complicare la dimostrazione.
Test di simmetria
Se la distribuzione è normale è necessariamente anche simmetrica attorno alla media, e quindi metà dei valori (n/2) saranno inferiori alla media e metà (n/2) saranno superiori (escludendo che esistano valori perfettamente identici alla media, o se ve ne fossero li togliamo dal conto). In
pratica, questo test corrisponde ad un confronto tra media e mediana. Si tratta in definitiva di confrontare il numero dei valori inferiori e superiori alla media contro il valore n/2.
Esempio
Immaginiamo il seguente campione:
4, 5, 8, 3, 4, 8, 4, 5, 6, 3, 4, 2, 3, 4, 9, 5
con media=4.81 e numerosità=16.
I valori inferiori alla media sono 9: 4, 3, 4, 4, 3, 4, 2, 3, 4
I valori superiori alla media sono 7: 5, 8, 8, 5, 6, 9, 5
contro le frequenze attese (n/2): 8 e 8.
Pertanto il test consisterà nel calcolo:
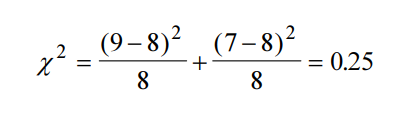
Anche questa volta il risultato non è statisticamente significativo. Ma si tratta di un campione molto piccolo, per semplificare la dimostrazione.
Questo χ2 ha 1 solo grado di libertà in quanto le frequenze attese sono date dalla media delle due frequenze osservate. Pertanto, se la frequenza osservata dei valori inferiori alla media varia in un senso rispetto alla frequenza attesa, la frequenza dei valori superiori necessariamente varierà in senso opposto. Quindi una sola delle due frequenze osservate è libera di variare.
Tabelle 2×2
La tabella 2X2 serve a valutare l’associazione tra due caratteri o a confrontare due proporzioni.
La tabella 2X2 è una normale tabella a due entrate. Ogni carattere ha due modalità che devono essere:
1. mutualmente esclusive (senza alcuna sovrapposizione)
2. esaustive (comprendere tutti i casi)
3. indipendenti (il fatto di trovare una certa modalità in un soggetto non influisce sulla modalità presente nel soggetto successivamente campionato né in tutti gli altri).
Alcuni esempi.
Esiste una relazione tra colore degli occhi e colore dei capelli?

La proporzione tra promossi/bocciati è uguale in due scuole?

Consideriamo il primo caso:
Ci si chiede se ci sia una certa relazione tra le modalità delle due variabili qualitative o caratteri. Se questa esiste, allora i rapporti tendono a divergere. Nel nostro esempio, tra le persone bionde, l’80% (24/30) ha gli occhi celesti, contro il 20% (6/30) con occhi occhi non celesti. Oppure, tra le persone con occhi non-celesti, solo il 6.25% (6/96) è biondo, contro il 93.75% (90/96) non-bionde. Se invece non c’è relazione, i rapporti tendono a coincidere.
Queste sono le frequenze osservate. Le frequenze attese sono quelle dell’ipotesi nulla, che rendono uguali le due proporzioni, in quanto l’ipotesi nulla sostiene che i rapporti siano uguali, e le differenze siano dovute al caso. Come al solito l’ipotesi nulla è l’ipotesi dello scettico. Ottenere le frequenze attese è semplice. Basta disegnare una nuova tabella e, per ogni casella, calcolare il prodotto totale riga X totale colonna e poi dividere per il totale generale:
Frequenze attese:

Notare che le frequenze attese lasciano inalterati i totali marginali di riga e di colonna.
Riassumendo:


Il valore trovato 33.47 è ben superiore al valore critico di χ2 con 1 grado di libertà, sia per α = 0.05 che per α = 0.01. Pertanto si rigetta l’ipotesi nulla, concludendo che esiste una relazione tra colore dei capelli e colore degli occhi.
Avrete notato come la differenza tra frequenza osservata e frequenza attesa sia pari a 13.5 in tutte le 4 caselle. Infatti, dovendo rispettare i totali marginali, se sottraiamo una certa quantità ad una casella dobbiamo aggiungere la stessa quantità alla casella adiacente, sia in verticale che in
orizzontale. Per questo motivo la tabella 2X2, pur sviluppando quattro quozienti, ha 1 solo grado di libertà. Mediante lo stesso ragionamento, una volta calcolata la frequenza attesa di una casella, le frequenze attese delle altre tre sono vincolate dal rispetto dei totali marginali, e infatti il modo
più semplice di calcolare le frequenze attese è per differenza rispetto alla prima.
Ma esiste una scorciatoia ancora maggiore, in quanto, è possibile utilizzare una formula che ci dà il χ2 in un solo passaggio. Se chiamiamo le 4 caselle con a, b, c, d, i 4 totali marginali saranno (a+b) (c+d) (a+c) (b+d) ed il totale generale n=a+b+c+d:

La formula immediata è:

che nel nostro caso darà χ2 = 33.23 corrispondente al 33.47 ottenuto in base al calcolo delle frequenze attese, con la differenza di
qualche decimale dovuta agli arrotondamenti.
ESEMPIO Test di bontà di adattamento (goodness-of-fit test)
In USA nascono più bambini il martedì e il mercoledì?
H0 = la probabilità di nascita è la stessa ogni giorno della settimana
H1 = la probabilità di nascita NON è la stessa ogni giorno della settimana
Modello sotto H0 le nascite sono proporzionali al numero di giorni della settimana durante l’arco dell’anno 1999.

Nel 1999 ci sono stati 52 Domeniche, Lunedì,…, e 53 Venerdì. Dunque mi attendo che:


Per un test goodness-of-fit:
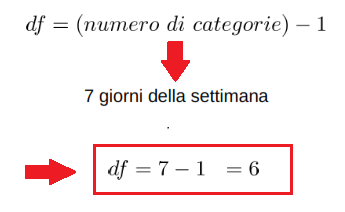

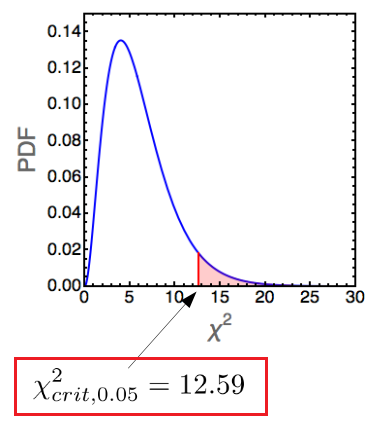
Se fosse vera l’ipotesi nulla ci attenderemo:
χ2calc ≅ 0
più è marcata la differenza tra osservati e attesi più è alto il valore di χ2.
χ2calc > χ2crit,0,05
Accettiamo dunque l’ipotesi alternativa: la probabilità di nascita NON è la stessa per ogni giorno della settimana!
Nota bene!
Assunzioni:
i dati sono un campione casuale estratto dall’intera popolazione nessuna delle categorie deve avere una frequenza attesa minore di 1 non più del 20% delle categorie deve avere frequenze attese minori di 5
possibile soluzione: raggruppare le categorie (e ricalcolare i gradi di libertà di conseguenza)
ESEMPIO
l progetto genoma umano ha individuato fino ad ora 20290 geni. Il cromosoma X contiene il 5.2% del DNA, e sono stati identificati 781 geni. Esistono su tale cromosoma tanti geni quanti ce ne attenderemmo se il numero di geni fosse proporzionale alla quantità di DNA?
H0 = La percentuale dei geni umani sul cromosoma X è il 5.2%
H1 = La percentuale dei geni umani sul cromosoma X NON è il 5.2% (NB: potrebbe essere maggiore o minore e dunque il test è a due code)
Ricordiamo che la distribuzione (discreta) binomiale descrive la probabilità di avere k successi su n prove indipendenti con probabilità p in test
vero/falso, sì/no. Dunque sotto l’ipotesi nulla possiamo immediatamente calcolare la probabilità che sul cromosoma X ci siano 0 oppure 1 oppure 2
oppure …oppure k geni e sommare tra loro queste probabilità. Poiché il test è a due code dobbiamo infine moltiplicare per 2…

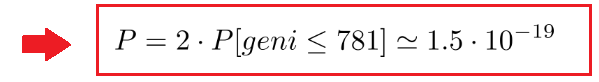
Dunque il fatto di aver osservato 781 geni sul cromosoma X è un fatto davvero raro. Il numero di geni su questo cromosoma è significativamente minore di quello che ci aspetteremmo in base alle dimensioni del cromosoma.
L’approccio che abbiamo seguito è rigoroso e esatto, ma assai laborioso. I conti possono essere eseguiti solo con un computer (a meno di metterci tantissimo tempo o impiegare tantissime persone).
Goodness-of-fit: 2 sole categorie
Il metodo alternativo si basa sul test χ2
H0 = La percentuale dei geni umani sul cromosoma X è il 5.2%
H1 = La percentuale dei geni umani sul cromosoma X NON è il 5.2%


…e arriviamo alla stessa conclusione che avevamo ottenuto usando la distribuzione binomiale anche se con un certo margine di approssimazione (ma con conti molto più semplici).
ESEMPIO Goodness-of-fit: modello con 1 parametro
sappiamo che il sesso nella specie umana è una variabile indipendente . Dunque ci attendiamo che in famiglie con 2 figli il numero di maschi sia conforme ad una distribuzione binomiale con n = 2 e p uguale alla probabilità di avere un maschio in ogni singola prova (p=0,5). È davvero così?
Due scienziati hanno analizzato i dati provenienti dal National Longitudinal Survey of Youth (NLSY)

L’ipotesi non ci dice nulla riguardo alla probabilità di avere un figlio maschio, e dunque dobbiamo cercare di calcolare questa probabilità a partire dai dati (ecco il parametro! La variabile chi quadro segue una distribuzione di densità di probabilità chi quadro con ν-b gradi di libertà dove b è il numero di parametri conosciuti della distribuzione ipotizzata quali ad esempio la media, la deviazione standard o il parametro di forma.)

H0 = Il numero di maschi nelle famiglie con due figli segue la distribuzione binomiale
H1 = Il numero di maschi nelle famiglie con due figli NON segue la distribuzione binomiale

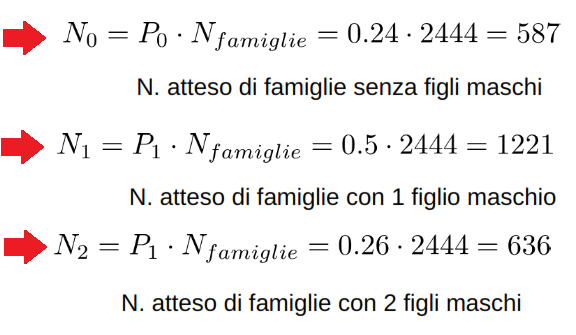
Usiamo questi valori per calcolare le frequenze attese:


ESEMPIO
I dati:
numerosità di osservazioni che cadono all’interno di determinate categorie
- Prima di tutto, è un test per confrontare proporzioni
- Esempio: confronto tra numero semi lisci e rugosi osservati in nella discendenza di una pianta eterozigote autofecondata
- DATI: 59 semi lisci e 14 semi rugosi o p = 59/73 = 0.808
- Ci si chiede di verificare l’ipotesi nulla che la proporzione di semi lisci, π0, sia 0.75
Sappiamo già affrontare questo problema con un semplice test z !
H0 ⇒ π = π0
H1 ⇒ π ≠ π0

Però questa analisi si può affrontare anche con il test del chi-quadrato, calcolando sulle numerosità (non sulle proporzioni) la statistica

dove:
- Osservati sono le numerosità osservate
- Attesi sono le numerosità attese se fosse vera l’ipotesi nulla
- La sommatoria è per tutte le categorie (2 in questo caso, semi lisci e semi rugosi)
- Come per il test z, questo test è valido se le numerosità attese nelle 2 categorie sono maggiori o uguali a 5
Nell’esempio
o Valori attesi di semi lisci, su un totale di 73 semi, è pari a 0.75*73 = 54.75
o Valori attesi di semi rugosi, su un totale di 73 semi, è pari a 0.25*73 = 18.25
o I valori attesi possono avere numeri decimali: sono medie di tante repliche ipotetiche di un esperimento sotto H0
o Il totale dei valori attesi deve essere pari al numero totale di osservazioni!
Per le verifica della significatività, ci servono i valori critici di una distribuzione teorica nuova, quella del χ2
Infatti si può dimostrare che se è vera l’ipotesi nulla (π= π0), allora la distribuzione della statistica (χ2calc) segue una distribuzione teorica nota, quella del χ2 appunto, con un numero di gradi di libertà pari al numero di categorie indipendenti.
gdl: numero di pezzettini di informazione indipendente oppure numero di pezzettini di informazione meno il numero di parametri stimati dai dati per calcolare gli attesi.
In questo caso, c’è soltanto 1 gdl, poichè:
esiste solo una classe indipendente (la numerosità nell’altra la posso calcolare per differenza dal totale)

- Tante curve a seconda dei gradi di libertà
- Il valore medio è uguale a il numero di gradi di libertà
- χ2 è sempre positivo (si calcola con un quadrato al numeratore)
- Varia tra 0 e +infinito
tabella del Chi-quadrato
I valori interni alla tabella corrispondono ai valori critici riferiti alla coda di destra, ovvero ai valori alla cui destra cade la frazione della curva riportata nella prima riga. Per esempio, con 2 gradi di libertà, il 5% della distribuzione ha valori superiori a 5.991. Si tratta quindi di una tabella delle aree a una coda.

Riprendiamo l’esempio dei semi lisci e rugosi:
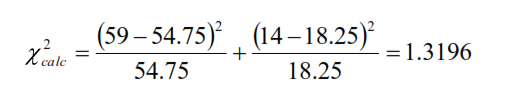
Quindi il valore di Chi quadrato calcolato χ2calc = 1.3196 non è significativo per α = 0.05, visto che è inferiore al valore critico di 3.841
La conclusione è ovviamente identica a quella ottenuta con il test z.
(5489)
Altri articoli nella categoria "Statistica"
- Funzioni Suriettive: Definizione, Calcolo Combinatorio ed Esercizi Svolti
- Indice di Laspeyres: formula, significato ed esercizi svolti
- Regressione lineare: esercizi progressivi dai minimi quadrati alla regressione multipla
- Test d’Ipotesi nel Marketing: Quando la Significatività Statistica Non Basta (Esercizi Svolti)
- Statistica per il Marketing: Come Usare i Test d’Ipotesi (Z-Test) per A/B Test e ROI
- Esercizi di Calcolo Combinatorio Applicato al Nudging di Richard Thaler: 6 Casi Aziendali Svolti per l’Architettura delle Scelte
- Test sulla Distribuzione Binomiale: 10 Esercizi Svolti (con Soluzioni e Valutazione)
- Legge di Benford e Data Quality nel Marketing: Guida, Formule ed Esercizi Python
- Calcolo Combinatorio: Come Risolvere i Problemi Senza Formule (con Esempi e Python)
- Teoria di Ramsey e R(3,3)=6: Dimostrazione, Grafo di K6 e Significato Combinatorio